بنچمارکها در هر دو معنای کلمه، حاکمان هوش مصنوعی هستند. به عنوان ابزارهای اندازهگیری، آنها طبق منطقی بسیار ساده عمل میکنند: اگر میخواهید بدانید یک مدل هوش مصنوعی چه کاری میتواند انجام دهد، یک آزمون استاندارد برای سنجش آن طراحی کنید. اما بنچمارکهای هوش مصنوعی میتوانند بر رفتار کل این حوزه نیز مسلط شوند.
در سال ۱۹۸۷، اولین بنچمارک آژانس پروژههای تحقیقاتی پیشرفته دفاعی (DARPA) در زمینه ترجمه خودکار گفتار به متن نشان داد که هوش مصنوعی پیشرفته نمیتواند از رویکردهای آماری به اصطلاح «کندذهن» پیشی بگیرد. عملکرد ضعیف در این آزمون به آغاز زمستان هوش مصنوعی کمک کرد. به مدت ۲۵ سال، علاقه به تحقیقات هوش مصنوعی کاهش یافت و بودجهها خشک شدند.
سپس در سال ۲۰۱۲، بنچمارک دیگری به نام ImageNet ورق را برگرداند. یک شبکه عصبی هشت لایهای، سایر الگوریتمها را در طبقهبندی تصاویر شکست داد و «انقلاب یادگیری عمیق» را آغاز کرد.
امروزه، بنچمارکهای جدید هوش مصنوعی که برای مدلهای زبانی بزرگ مانند GPT-6 Astra شرکت OpenAI طراحی شدهاند، با نظم و قاعدهای خاص ایجاد و حل میشوند و ادعا میکنند که همه چیز، از تخصص در حوزههای خاص گرفته تا «هوش عمومی» را اندازهگیری میکنند. اما بسیاری از افراد در این حوزه — چه شکاکان و چه طرفداران — به جای استقبال از این روند به عنوان اثباتی بر پتانسیل سرسامآور هوش مصنوعی، آن را نشانهای از این میدانند که خودِ بنچمارکگیری به شدت دچار نقص شده است.
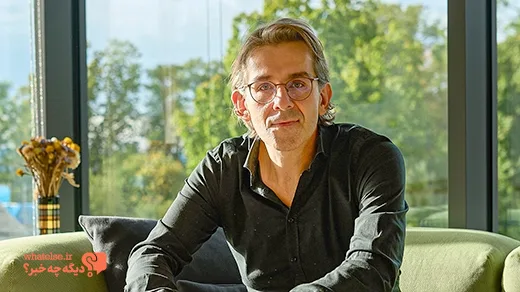
موریتس هاردت، دانشمند علوم کامپیوتر و مدیر موسسه سیستمهای هوشمند ماکس پلانک، با این تشخیص موافق است. او مدت کوتاهی پس از نتایج ImageNet، شروع به فکر کردن در این باره کرد که سیستمهای یادگیری ماشین میتوانند بدون انجام هیچ کار هوشمندانهای، لیدربوردها را بازی دهند. او گفت: «هیچ راه دومی وجود ندارد. اکوسیستم بنچمارکگیری خراب است.»
هاردت در کتاب سال ۲۰۲۶ خود با عنوان علم نوظهور بنچمارکهای یادگیری ماشین، این استدلال تحریکآمیز را مطرح میکند که این ابزارهای اندازهگیری دهههاست که خراب بودهاند: او مینویسد که بنچمارکها «اشتباهی بودند که یادگیری ماشین را ساختند.» نکته قابل توجه این است که او استدلال میکند آنها به جای ایجاد بحران تکرارپذیری، به هر حال باعث پیشرفت مشروع شدند — که به نظر او «عمدتاً به دلیل شانس محض» بوده است. با درک دلیل این موضوع، میتوانیم توضیح دهیم که چگونه بنچمارکها از آن زمان اعتبار تصادفی خود را در عصر مدلهای زبانی بزرگ (LLM) از دست دادهاند و چگونه ممکن است دوباره آن را به دست آورند.
کوانتا با هاردت درباره آنچه در مورد بنچمارکها اشتباه و درست بوده و مسیر آینده آنها صحبت کرد. این مصاحبه برای وضوح بیشتر خلاصه و ویرایش شده است.
بیایید اصول اولیه را روشن کنیم: بنچمارک اصلاً چیست؟
دستورالعمل ساده است. برای ارزیابی یک مدل یادگیری ماشین، دادههای خود را میگیرید و آنها را به یک مجموعه آموزشی و یک مجموعه تست تقسیم میکنید. به سازندگان مدل اجازه میدهید هر کاری که میخواهند روی مجموعه آموزشی انجام دهند: هر چیزی مجاز است، هیچ قانونی وجود ندارد. اما از مجموعه تست فقط برای مقایسه و رتبهبندی مدلها استفاده میکنید — تا لیدربوردی داشته باشید که بگوید: «این در حال حاضر پیشرفتهترین است، این شماره یک است، این شماره دو است.»
هیچ راه دومی وجود ندارد. اکوسیستم بنچمارکگیری خراب است.
موریتس هاردت
بنابراین یک بنچمارک برای یک مدل زبانی بزرگ امروزی، مانند GPT-6 Astra یا Claude Fable، ممکن است توانایی حل مسائل دشوار ریاضی یا یافتن باگهای امنیتی در نرمافزار را آزمایش کند.
درست است. در واقع، اولین بنچمارک در سال ۱۹۵۹ ایجاد شد. این مجموعهای از ارقام و حروف چاپ شده روی کارتهای پانچ بود که برای آزمایش میزان توانایی اسکنرهای مختلف در تشخیص کاراکترهای نوشتاری طراحی شده بود. کسی تقسیمبندی آموزش-تست را معرفی کرد و یک لیدربورد راه انداخت.
اینطور نبود که طرحی استادانه وجود داشته باشد. اما این همان چیزی است که ما اکنون آن را بنچمارکگیری مینامیم و حدود ۶۰ سال است که موتور پیشرفت در هوش مصنوعی بوده است.
بنچمارکها قرار است چه چیزی را به ما بگویند؟
به طور سنتی، یک بنچمارک قرار است مانند یک دماسنج باشد. افراد مدلی را برای انجام کاری آموزش میدهند و سپس شما نوعی روش اندازهگیری ابداع میکنید تا ببینید مدل چقدر خوب است.
اما در عمل، بنچمارکگیری بیشتر شبیه یک مسابقه ورزشی یا یک بازار است. بنچمارکها قوانین بازی را تعیین میکنند و افراد فعالانه بر سر آنها رقابت میکنند و ما اجازه میدهیم بهترین مدل برنده شود.
آیا نمیتوانند هر دو باشند؟ مشکل چیست؟
هر کتاب درسی یادگیری ماشین درباره «روش هولد-اوت» (holdout method) به شما میگوید — اینکه باید مجموعه تست را قفل کنید و فقط یک بار برای رتبهبندی مدلها از آن استفاده کنید. اگر این را نادیده بگیرید، روی یخ نازک راه میروید. ممکن است نتایج بسیار گمراهکنندهای بگیرید زیرا در حال ارزیابی مدلهایی هستید که به نوعی از مجموعه تست آگاهی دارند.
نکته جالب این است که یادگیری ماشین به عنوان یک رشته، این هشدار را نادیده گرفت. تمام این مجموعههای تست را گرفت و برای استفاده همه در اینترنت قرار داد. قرار دادن این مجموعههای تست در حلقه توسعه یک مدل و تکرار مداوم روی آنها آسان است.
آیا این همان چیزی است که در مورد بنچمارکها «خراب» است؟
اگر به اعداد دقت یک مدل در یک بنچمارک نگاه کنید و سپس مجموعه تست را فقط کمی تغییر دهید، اعداد دقت کاملاً متفاوتی دریافت میکنید. این همان معنایی است که در آن بنچمارک کار نمیکند. اگر در یک مجموعه داده ۹۰٪ دقت و در دیگری ۷۳٪ دقت دارید، کدام درست است؟ من هیچ ایدهای ندارم که این مدل چقدر خوب است.
شرکتهای OpenAI، Anthropic و سایر شرکتهای فناوری هنوز اعداد بنچمارک را به عنوان معیاری از تواناییهای استدلال مدلهای خود تبلیغ میکنند. آیا این فقط مزخرف است؟
این امتیازات واقعاً مورد سوءاستفاده قرار میگیرند. اگر بگویید: «در این بنچمارک ریاضی، مدل ۹۰٪ امتیاز گرفت، که یعنی مدل اکنون معادل یک ریاضیدان متخصص است»، شما چیزی را از آن عدد برداشت میکنید که نتیجهگیری اشتباهی به شما میدهد. ما باید از مقایسهها یا نتیجهگیریهایی که به طور ضمنی مستلزم معنادار بودن عدد مطلق هستند، اجتناب کنیم.
اگر اعداد مطلق معنادار نیستند، چگونه به بحران تکرارپذیری نمیرسید؟
اینجاست که اوضاع واقعاً جالب میشود. اگر به جای اعداد مطلق، به رتبهبندیها نگاه کنید — مقایسههای نسبی بین مدلها — آن رتبهبندیها در مجموعههای داده مختلف بسیار پایدار هستند. و این در طول تاریخ یادگیری ماشین کاملاً ثابت بوده است. اگر یک مدل در یک مجموعه تست خاص ۹۰٪ و مدل دیگری ۸۰٪ بگیرد، آنگاه مدل ۹۰٪ مدلی است که میخواهید در دنیای واقعی استفاده کنید. این مدل همچنان در مجموعههای داده دیگر، حتی آنهایی که کاملاً متفاوت از مجموعه تست هستند، عملکرد بهتری خواهد داشت.
این، برای من، دلیل اصلی فرار یادگیری ماشین از یک بحران علمی است.
ما در حال حاضر در این بحران بنچمارکگیری هستیم — زیرا دیگر اینطور نیست که مدل بهتر لزوماً برنده شود.
موریتس هاردت
این تعجبآور است. بنابراین امتیاز ۹۰٪ اعتبار زیادی ندارد، اما این واقعیت که در مسابقه «برنده» شده است، اعتبار دارد؟
بله. بنابراین بنچمارکها به شما میگویند که چه زمانی بهترینِ قبلی را شکست دادهاید. و این شاخصهای بهبود کاملاً قابل اعتماد هستند.
اما خوششانسی است که این کار به این خوبی جواب داد — ما هیچ دلیلی نداشتیم که انتظار داشته باشیم اینطور باشد. و ما هنوز نظریه جامع خوبی برای دلیل این اتفاق نداریم. این عمدتاً یک پدیده تجربی است.
اما شما همچنین استدلال میکنید که اکنون، در عصر مدلهای زبانی بزرگ، بنچمارکها دیگر قادر به ارائه این قابلیت اطمینان «تصادفی» نیستند. چرا نه؟
پایداری رتبهبندی مدلها یک نکته مهم دارد: مدلها باید روی مجموعه آموزشی یکسانی آموزش ببینند. در گذشته، این همیشه درست بود. اما ما نمیدانیم LLMها روی چه چیزی آموزش دیدهاند. در واقع، سازندگان مدل میتوانند به صورت استراتژیک ترکیبهای دادهای را جمعآوری کنند که عملکرد بنچمارک را به بهترین نحو ارتقا دهد. این کمی شبیه درس خواندن برای امتحان است، کاری که همه ما در دبیرستان انجام میدهیم.
به همین دلیل است که ما در حال حاضر در این بحران بنچمارکگیری هستیم — زیرا دیگر اینطور نیست که مدل بهتر لزوماً برنده شود. یک مدل ضعیفتر ممکن است فقط تلاش بیشتری برای آمادهسازی برای آن بنچمارک خاص انجام داده باشد.
این واقعاً یک جرم نیست: هر بار که مدل جدیدی منتشر میشود، این اتفاق میافتد. اگر به یادداشتهای آخرین نسخه Gemini یا GPT نگاه کنید، خواهید دید که عملکرد آن در بنچمارکهایی که قبل از مدل جدید منتشر شدهاند اغلب فوقالعاده است، در حالی که عملکرد آن در بنچمارکهایی که کمی بعد منتشر شدهاند بسیار پایینتر است. این همیشه نشانهای از این است که مدل روی بنچمارک قبلی «پسآموزش» (post-trained) شده است — چیزی که برخی آن را «بنچمکس» (benchmaxxed) مینامند. و این به طور کلی پذیرفته شده است.
آیا راهی برای خروج از این بحران بنچمارکگیری، همانطور که شما آن را مینامید، وجود دارد؟
بگذارید داستانی برایتان بگویم: در المپیک ۱۹۶۸ مکزیکوسیتی، یک دونده آمریکایی وجود داشت که به طور گستردهای شانس اول برنده شدن در مسابقه ۱۵۰۰ متر بود. او به طور غیرمنتظرهای با اختلاف زیاد به دوندهای از ارتفاعات کنیا باخت. دونده کنیایی در ارتفاع بالا تمرین کرده بود و برای رقابت در ارتفاع ۷۵۰۰ فوتی از سطح دریا آمادگی بهتری داشت. این موضوع بحثبرانگیز شد: آیا باید تمرین در ارتفاع را ممنوع کنیم؟ اجماع در نهایت این بود که فقط اجازه دهید همه این کار را انجام دهند.
مشکل این نیست که مردم خود را با بنچمارکها بهینه میکنند — مشکل این است که آنها در درجات مختلف بهینه میکنند. اگر همه بهینه کنند، یا «تمرین در ارتفاع» انجام دهند، اعداد مطلق متورم میشوند، اما میتوانید اعتبار رتبهبندیها را بازیابی کنید.
تمرین در ارتفاع برای بنچمارکهای هوش مصنوعی چگونه خواهد بود؟
ما از قبل نمیدانیم چه چیزی وارد این مدلها شده است، اما میتوانیم آنها را کمی روی دادههای مرتبط با بنچمارک آموزش دهیم، فقط برای اطمینان از اینکه تا حدودی زمین بازی را برای همه یکسان میکنیم.
در این دیدگاه جدید از بنچمارکها، شما هیچ مجموعه آموزشی نخواهید داشت. شما یک مجموعه تست خواهید داشت و همچنین نوعی پروتکل برای آمادهسازی هر یک از مدلها قبل از آزمایش آنها خواهید داشت — این همان تمرین در ارتفاع است.
اما حتی اگر این کار جواب دهد، ما فقط به جایی برمیگردیم که از آن شروع کردیم: شاخصهای پیشرفت، اما بدون اندازهگیریهای معتبر. بدون آن، چگونه میتوانیم چیزی درباره نحوه کار مدلها یاد بگیریم؟
این سوال واقعاً جالبی است. چیزی غمانگیز در پیروزی بنچمارکگیری وجود دارد، زیرا به نظر میرسد ما در حال رها کردن چیزی هستیم که علم واقعاً درباره آن است: درک مکانیسمها. اما اگر نوعی نظریه ریاضی بزرگ برای ساخت این مدلها داشتیم، نیازی به بنچمارکها نداشتیم.
ما نمیدانیم این مدلها چگونه این کار را انجام میدهند و بنچمارکگیری به ما نخواهد گفت.
اما بنچمارکگیری میتواند در درازمدت به دانش علمی جدید منجر شود. بنچمارک تاشوی پروتئین CASP بدون اصرار اولیه بر یک نظریه علمی درباره تاشوی پروتئین، علم را پیش برد. این قدرت متناقض بنچمارکگیری در علوم است.
منبع و مطالعه گزارش کامل به زبان اصلی: Quanta Magazine
دیدگاهها و نقدها
دیدگاه خود را درباره این تحلیل با دیگر خوانندگان به اشتراک بگذارید.
ارسال دیدگاه جدید
هنوز دیدگاهی برای این مقاله ثبت نشده است.
نخستین نفری باشید که دیدگاه یا نقد خود را درباره این موضوع مینویسد.